Dependency Injection in Ruby: lose Kopplung für Rails
Ein Unit-Test für die Registrierung, und plötzlich landet eine Willkommensmail in der Mailer-Queue, während im Hintergrund ein HTTP-Request an den Zahlungsdienst rausgeht. Wer das kennt, hat ein Kopplungsproblem. Dependency Injection in Ruby löst es mit Bordmitteln: Ein Objekt bekommt seine Abhängigkeiten von außen übergeben, statt sie selbst zu erstellen. Annotationen oder XML-Konfiguration wie in Java brauchst du dafür nicht. Die Umsetzung kommt ohne Gem aus.
So sieht der typische Ausgangspunkt aus:
class SignupService
  def call(attrs)
    user = User.create!(attrs)
    Billing::Client.new.create_customer(email: user.email)
    UserMailer.with(user:).welcome.deliver_later
    user
  end
end
Drei Abhängigkeiten, alle hart verdrahtet. Die Abhängigkeiten zu konkreten Klassen stehen fest im Code, und jedes Objekt erstellt die Klasse selbst. Testen kannst du das nur, indem du Billing::Client und UserMailer global stubbst.
Was Dependency Injection in Ruby bedeutet und warum sie oft unterschätzt wird
Dependency Injection ist ein Entwurfsmuster und eine Form von Inversion of Control: Die Klasse entscheidet nicht mehr selbst, welche Implementierung sie verwendet. Sie erklärt nur, was sie benötigt, und wer sie aufruft, muss es zur Verfügung stellen. In Java oder C# übernehmen das meist Frameworks wie Spring mit eigener Konfiguration.
Viele Ruby-Entwickler belächeln das Entwurfsmuster. DHH hat 2013 in seinem Blogbeitrag „Dependency injection is not a virtue“ argumentiert, dass Ruby so etwas nicht braucht, weil du in Specs ohnehin jede Konstante zur Laufzeit umbiegen kannst. Das stimmt technisch. Der Haken: Ein Stub auf UserMailer gilt für den ganzen Testfall statt für ein einzelnes Objekt, und er verrät dir nicht, welche Abhängigkeiten eine Klasse überhaupt hat.
Ruby macht Injektion außerdem billig. Durch Duck Typing brauchst du kein formales Interface wie in Java oder PHP: Jedes Objekt, das die erwartete Methode implementiert, passt. In Ruby kann jedes Objekt Abhängigkeit sein: Klassen sind selbst Objekte, du kannst also UserMailer als Wert übergeben. Oft reicht sogar ein Lambda.
Konstruktor-Injektion mit Default-Argumenten: das idiomatische Ruby
Die einfachste Variante ist Constructor Injection mit Keyword-Argumenten und Standardwerten:
class SignupService
  def initialize(billing: Billing::Client.new,
                 notifier: ->(user) { UserMailer.with(user:).welcome.deliver_later })
    @billing = billing
    @notifier = notifier
  end

  def call(attrs)
    user = User.create!(attrs)
    billing.create_customer(email: user.email)
    notifier.call(user)
    user
  end

  private

  attr_reader :billing, :notifier
end

SignupService.new.call(signup_params)                   # Produktion
SignupService.new(billing: FakeBilling.new).call(attrs) # Test
Der Produktionscode verwendet weiter SignupService.new ohne Argumente. Die attr_reader stehen unter private, damit die Abhängigkeiten nicht zur öffentlichen Schnittstelle gehören. In der Testsuite injizierst du gezielt eine andere Abhängigkeit, ohne den Service zu ändern. Wichtig zu wissen: Ruby wertet Default-Ausdrücke bei jedem Aufruf neu aus. Jedes new erstellt also einen frischen Billing::Client. Im Fall eines geteilten HTTP-Clients mit Connection-Pool übergibst du deshalb besser eine Konstante oder einen Memo-Wert.
Setter-Injektion über attr_writer ist eine Alternative, aber die schwächere. Das Objekt existiert dann eine Weile in einem halbfertigen Zustand. Für Pflichtabhängigkeiten würde ich immer initialize nehmen.
Vorteile und Nachteile der Constructor Injection
Bevor du jeden Service umbaust, lohnt ein ehrlicher Blick auf beide Seiten:
- Vorteil: Die Abhängigkeiten stehen sichtbar in der Signatur. Wer die Klasse liest, sieht sofort, welches Interface sie von außen erwartet.
- Vorteil: Unterschiedliche Implementierungen lassen sich ohne Änderung im Code verwenden, etwa ein Sandbox-Client für Staging und ein Fake für die Testsuite.
- Nachteil: Ab vier oder fünf Argumenten wird
initializeunübersichtlich. Meist ist das ein Hinweis, dass die Klasse zu viel erledigt. - Nachteil: Die Default-Werte nennen weiter echte Klassennamen. Zur Laufzeit ist die Kopplung gelöst, im Quelltext nicht ganz. In Rails mit Zeitwerk stört das praktisch nie.
Klassenmethoden vs. Instanzen: warum viele self.-Methoden das Testen erschweren
In vielen Rails-Codebasen findest du Module, die nur def self.-Methoden enthalten. Sie fühlen sich leichtgewichtig an, haben aber keinen Ort für Abhängigkeiten. Was eine Klassenmethode braucht, muss sie über Konstanten selbst erstellen oder holen. Damit bleibt dir in der Spec nur allow(Billing::Client).to receive(:new), und dieser Stub ändert das Verhalten der Konstante für alle Stellen im selben Testlauf.
Dazu kommt, dass Klassenmethoden zu Zustand auf Klassenebene verleiten, etwa @@cache oder Class-Instance-Variablen. Der lebt, solange der Prozess des Programms läuft, also auch von einem Testfall zum nächsten. Fehler hängen dann von der Reihenfolge ab.
Die Lösung ist einfach und kostet eine Zeile. Behalte den bequemen Einstieg auf Klassenebene, aber delegiere an eine Instanz:
class SignupService
  def self.call(attrs) = new.call(attrs)
  # initialize und call wie oben
end
So bleibt SignupService.call(attrs) im Controller kurz, und die Testsuite baut sich die Instanz mit eigenen Abhängigkeiten.
Service-Objekte als natürlicher Ort für Abhängigkeiten
Service-Objekte bringt Rails nicht mit, sie sind eine Konvention aus der Community. Für die Umsetzung legst du sie meist unter app/services ab. Weil Zeitwerk jedes Unterverzeichnis von app als Autoload-Pfad behandelt, brauchst du dafür keine Konfiguration. Ein Service kapselt genau einen Anwendungsfall und liefert über eine öffentliche Methode, meist call, ein Ergebnis zurück.
Für die Injektion passen Service-Objekte gut. Bei ihnen kommen Modelle und externe Komponenten zusammen. Der Controller bleibt dünn:
class SignupsController < ApplicationController
  def create
    user = SignupService.call(signup_params)
    redirect_to dashboard_path, notice: "Willkommen, #{user.name}"
  rescue ActiveRecord::RecordInvalid => e
    @user = e.record
    render :new, status: :unprocessable_entity
  end
end
Konkret heißt das: Controller-Tests prüfen Routing und Antwortcodes, Service-Tests prüfen die Fachlogik mit injizierten Fakes.
Hooks und Callbacks: wann explizite Aufrufe besser sind
Rails bietet zwei Callback-Ebenen. Mit ActiveSupport::Callbacks steckt bereits ein allgemeines Werkzeug im Framework, mit define_callbacks, set_callback und run_callbacks. Darauf bauen die ActiveRecord-Callbacks wie after_create oder after_commit auf, ebenso Controller-Filter wie before_action.
In Bibliotheken und Frameworks sind Callbacks gut aufgehoben. Für Geschäftslogik werden sie schnell zur versteckten Abhängigkeit. Ein Model, das after_create :send_welcome_mail enthält, feuert bei jedem User.create, auch in Seeds und in jeder Factory. Gleichzeitig überspringen Methoden wie update_column, update_all oder insert_all die Callbacks komplett, wie die Rails Guides zu Active Record Callbacks auflisten. Deine Logik läuft also manchmal zu oft und manchmal gar nicht.
Vorher und nachher im Vergleich:
# vorher: versteckter Seiteneffekt im Model
class User < ApplicationRecord
  after_create_commit { UserMailer.with(user: self).welcome.deliver_later }
end

# nachher: Model kümmert sich um Daten, der Service um den Ablauf
class User < ApplicationRecord
  normalizes :email, with: ->(email) { email.strip.downcase }
end
Meine Faustregel: Callbacks sind in Ordnung, solange sie nur die Daten des eigenen Datensatzes betreffen, etwa beim Normalisieren oder beim Setzen von Defaults. Seit Rails 7.1 erledigt normalizes einen Teil davon sogar ohne Callback. Alles, was andere Objekte oder externe Systeme anspricht, gehört als expliziter Aufruf in einen Service. Für den Fall, dass du extern kommunizieren musst und beim Callback bleibst, nimm after_commit, damit kein Request für eine zurückgerollte Transaktion rausgeht.
dry-auto_inject und dry-core: wann sich das lohnt
Wächst die Zahl der Abhängigkeiten, wird die Signatur von initialize lang. Eine Alternative ist dry-auto_inject, aktuell in Version 1.2.1 vom Mai 2026. Das Gem erzeugt die Konstruktor-Injektion aus einer Liste von Schlüsseln und funktioniert mit jedem Objekt, das #[] versteht.
Als Registry empfiehlt die dry-rb-Dokumentation inzwischen Dry::Core::Container aus dry-core. Das eigenständige Gem dry-container steht dort unter „Deprecated“, seine letzte Version 0.11.0 stammt vom September 2022.
require "dry/core"
require "dry/auto_inject"

AppContainer = Dry::Core::Container.new
AppContainer.register("billing") { Billing::Client.new }
AppContainer.register("notifier") { WelcomeNotifier.new }

Import = Dry::AutoInject(AppContainer)

class SignupService
  include Import["billing", "notifier"]

  def call(attrs)
    user = User.create!(attrs)
    billing.create_customer(email: user.email)
    notifier.call(user)
    user
  end
end

SignupService.new(billing: FakeBilling.new) # notifier kommt aus dem Container
Standardmäßig injiziert dry-auto_inject über Keyword-Argumente, deshalb kannst du in Specs einzelne Abhängigkeiten überschreiben. Wer noch mehr Struktur will, landet bei dry-system. Es registriert Komponenten automatisch, Hanami 2 baut darauf auf. Das Verzeichnis ist dann die eine Stelle des Programms, an der festgelegt wird, welche Implementierung läuft. In einer normalen Rails-App würde ich das erst ab etwa fünf geteilten Abhängigkeiten pro Service einsetzen. Darunter sind Default-Argumente lesbarer, und jeder Entwickler im Team versteht sie ohne Einarbeitung.
Die Ansätze im Vergleich
| Ansatz | Kopplung | Testbarkeit | Aufwand | Passt für |
|---|---|---|---|---|
| Konstanten hart im Code | hoch | nur über globale Stubs | keiner | Prototypen, Skripte |
Klassenmethoden mit self. |
hoch | globale Stubs, Zustand leckt | gering | reine Funktionen ohne Seiteneffekte |
| Konstruktor-Injektion mit Defaults | gering | sehr gut, gezielt pro Objekt | gering | Standard für Services |
Setter-Injektion (attr_writer) |
gering | gut | gering | optionale Abhängigkeiten |
| dry-auto_inject mit Registry | gering | sehr gut | mittel (Gem, Registry-Setup) | viele geteilte Abhängigkeiten |
| ActiveRecord-Callbacks | hoch, versteckt | schlecht, feuern überall | gering | Normalisierung im eigenen Datensatz |
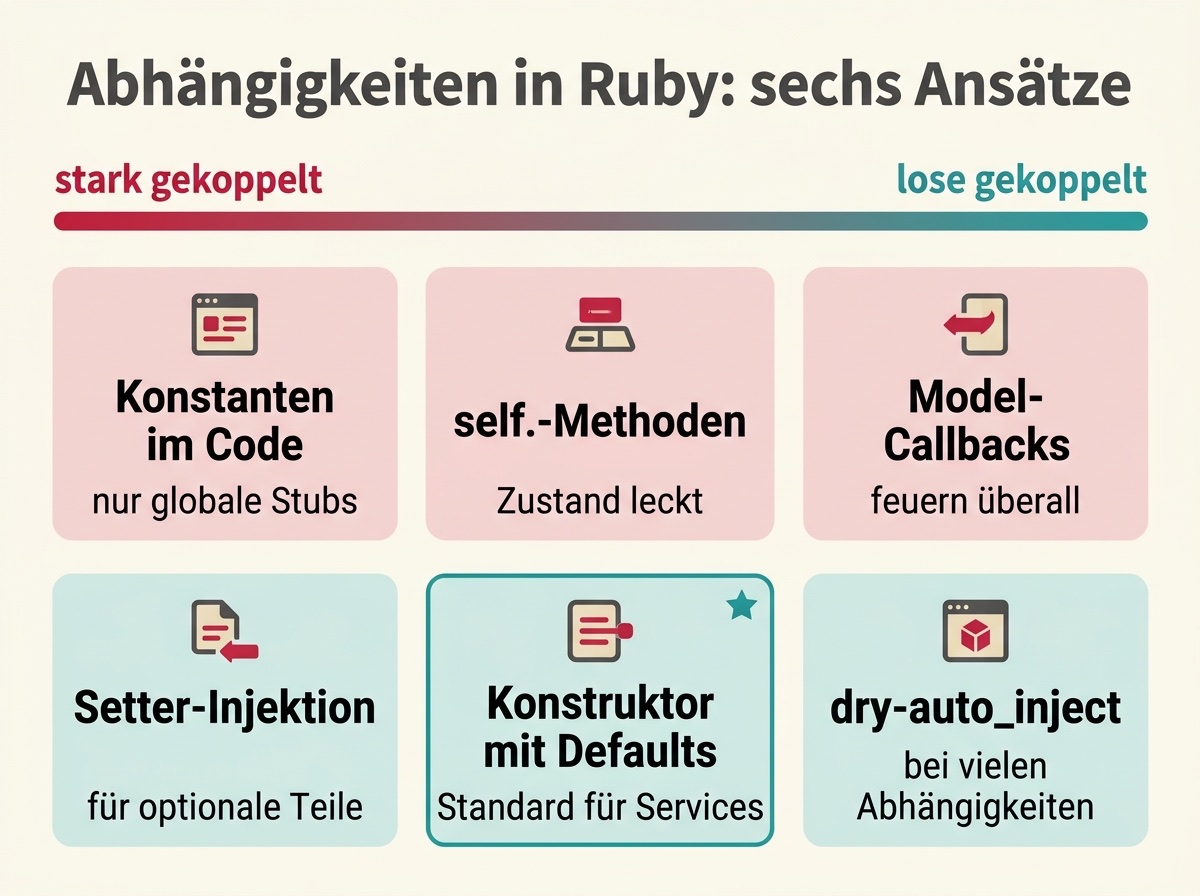
Von hart verdrahtet bis dry-auto_inject: so schneiden die Ansätze bei Kopplung und Testbarkeit ab.
Testen mit injizierten Fakes
Der eigentliche Gewinn zeigt sich beim Testen. Rails verwendet auch in Version 8 Minitest als Standard, das Beispiel funktioniert mit RSpec genauso:
class FakeBilling
  attr_reader :customers

  def initialize
    @customers = []
  end

  def create_customer(email:) = @customers << email
end

class SignupServiceTest < ActiveSupport::TestCase
  test "legt Kunden an und benachrichtigt den Benutzer" do
    billing = FakeBilling.new
    notified = []
    service = SignupService.new(billing:, notifier: ->(user) { notified << user })

    user = service.call(name: "Ada", email: " ADA@example.com ")

    assert_equal ["ada@example.com"], billing.customers
    assert_equal [user], notified
  end
end
Diese Prüfung braucht weder Stubs noch eine Mailer-Queue. Der Fake besteht einfach aus zwei Methoden, die du in Sekunden liest. Ein Problem haben Fakes allerdings: Sie können auseinanderlaufen, wenn sich das Interface der echten Klasse ändert. In RSpec hilft instance_double(Billing::Client), denn es schlägt fehl, sobald du eine Methode stubbst, die die echte Klasse nicht implementiert. Für eigene Fakes lohnt eine kleine gemeinsame Prüfung, die Fake und Original gegen dieselben Erwartungen laufen lässt.
In der Testsuite ersetzen schlanke Fakes Mailer und Zahlungsdienst.
Checkliste für lose gekoppelten Ruby-Code
- Frag bei jeder Klasse: Welche Abhängigkeit benötigt sie wirklich, und wer stellt sie zur Verfügung?
- Jede Klasse mit Seiteneffekten nimmt ihre Abhängigkeiten als Keyword-Argumente in
initializeentgegen. - Defaults zeigen auf die Produktionsimplementierung, damit Aufrufer nichts übergeben müssen.
def self.calldelegiert annew.call, statt selbst Logik zu enthalten.- Model-Callbacks fassen nur den eigenen Datensatz an, Mails, Jobs und API-Calls stehen explizit im Service.
- Externe Kommunikation aus Callbacks läuft über
after_commit. - Injiziere in Specs Fakes oder Lambdas, statt Konstanten global zu stubben.
- dry-auto_inject mit Registry führst du erst ein, wenn Konstruktoren unübersichtlich werden.
Wenn du nur einen Punkt umsetzt, nimm den ersten: Konstruktor-Injektion mit Default-Argumenten kostet eine Zeile pro Abhängigkeit und macht jeden Service testbar. Weitere Praxisartikel zu Ruby und Rails findest du in der Rubrik Technik.