Monolith oder Microservices: Wann sich der Schnitt lohnt
Die Frage „Monolith oder Microservices“ taucht meist an einem schlechten Tag auf. Ein Deployment hat das Checkout lahmgelegt, obwohl nur jemand am Newsletter gearbeitet hat. Im Daily fällt dann der Satz: „Wir müssen das aufteilen.“ Verständlich. Nur verschwindet ein Kopplungsproblem nicht, wenn zwischen den beiden Code-Teilen plötzlich ein Netzwerk liegt. Meine Einschätzung: Die meisten Rails-Projekte brauchen zuerst klare Grenzen im eigenen Code. Ob daraus später eine Microservices-Architektur wird, klärst du, sobald Messwerte und Teamstruktur dafür sprechen.
Woran ein Monolith wirklich krankt
Ein Rails-Monolith ist ein Deployment-Monolith. Es gibt eine Codebasis und ein Artefakt, das bei jedem Release komplett ausgerollt wird. Das ist kein Fehler. Eine monolithische Architektur hat handfeste Vorteile: Fehlersuche und Datenbank-Transaktionen sind in einem einzigen Prozess einfach, und ein neues Teammitglied hat die gesamte Anwendung nach bin/setup lokal laufen. Kleine Unternehmen mit einem Team arbeiten damit oft besser als mit zehn Diensten.
Die Nachteile von Deployment-Monolithen zeigen sich erst mit der Größe. Skaliert wird immer das gesamte System, auch wenn nur ein bestimmter Teil unter Last steht. Neue Technologien lassen sich schwer einführen, weil alle Komponenten dieselbe Ruby-Version und dieselben Gems teilen.
Richtig schwierig wird es, wenn jede Klasse jede andere kennt. Dann entsteht, was in der Literatur „Big Ball of Mud“ heißt: eine Struktur ohne erkennbare Grenzen, in der jede Änderung etwas an einer Stelle bricht, mit der niemand gerechnet hat.
In Rails-Projekten führt der Weg dorthin oft über das alte Mantra „Fat Model, Skinny Controller“. Die Logik wandert aus dem Controller ins Model. Irgendwann hängen am Order-Model Callbacks für Rechnung und Lager, später auch für Mails und Statistik. Damit ist das Single-Responsibility-Prinzip dahin, nach dem eine Klasse genau einen Grund haben sollte, sich zu ändern. Acht Callbacks bedeuten acht Gründe.
Typische Symptome:
- Ein Test für die Registrierung braucht Fabriken für Bestellungen, Rechnungen und Produkte.
has_many-Ketten laufen quer durch fachliche Bereiche, die wenig miteinander zu tun haben.- Niemand traut sich, eine Spalte umzubenennen, weil unklar ist, welcher Code sie liest.
- Der CI-Lauf dauert so lange, dass ihn keiner mehr lokal startet.
Keines dieser Symptome verschwindet, wenn du dieselbe Verflechtung über HTTP abbildest. Es kommt Latenz dazu. Und der Stacktrace endet an der Netzwerkgrenze.
Erster Schritt: Logik aus dem Model holen
Bevor es um Module oder Infrastruktur geht, gehört die Geschäftslogik in eigene Objekte. In Rails heißen sie meist Service-Objekte, bei Trailblazer Operations. Das Prinzip bleibt gleich: Ein Objekt bildet genau einen Anwendungsfall ab und hat möglichst nur eine öffentliche Methode. Ein Beispiel:
# app/services/orders/place_order.rb
module Orders
  class PlaceOrder
    def self.call(...) = new(...).call

    def initialize(cart:, payment_gateway: Payments::Gateway.new)
      @cart = cart
      @payment_gateway = payment_gateway
    end

    def call
      Order.transaction do
        order = Order.create!(cart: @cart, total_cents: @cart.total_cents)
        @payment_gateway.charge!(order.total_cents, reference: order.id)
        order
      end
    end
  end
end
Der Controller ruft nur noch Orders::PlaceOrder.call(cart: current_cart) auf. Das Model kümmert sich um Validierungen und Assoziationen. Der Anwendungsfall steht an einer Stelle und lässt sich lesen, ohne dass du fünf Callbacks im Kopf behalten musst. Das Gateway kommt über den Konstruktor herein; wie du solche Abhängigkeiten sauber übergibst, zeigt der Artikel über Dependency Injection in Ruby. Im Test reichst du ein Fake-Gateway hinein und sparst dir HTTP-Mocking. Für die tägliche Entwicklung heißt das: Tests ohne Netzwerk.
Der Haken: Service-Objekte allein ziehen noch keine Grenzen. Sie liegen weiterhin alle in app/services, und jedes darf jedes Model anfassen.
Der Modulith: Grenzen ohne Netzwerk
Ein modularer Monolith, kurz Modulith, bleibt ein einziges Deployment. Intern ist er in fachliche Module zerlegt. Die Kommunikation zwischen ihnen läuft ausschließlich über definierte Schnittstellen. Angestrebt werden hohe Kohäsion innerhalb eines Moduls und lose Kopplung zwischen den Modulen. Schneide fachlich, nach einem Bounded Context aus dem Domain-Driven Design, also etwa Abrechnung oder Versand. Ein technischer Schnitt nach Verzeichnissen wie „Models“ und „Jobs“ bringt dir dabei gar nichts. Wichtig ist, dass jedes Modul seine Daten selbst besitzt.
In der Rails-Welt haben sich zwei Werkzeuge für den Modulith durchgesetzt.
Rails Engines
Eine Engine ist laut den offiziellen Rails Guides zu Engines eine Miniatur-Anwendung, die ihrer Host-Anwendung Funktionen bereitstellt. Mit isolate_namespace landet alles, was die Engine mitbringt, in einem eigenen Namespace.
# Erzeugen: rails plugin new components/billing --mountable
# components/billing/lib/billing/engine.rb
module Billing
  class Engine < ::Rails::Engine
    isolate_namespace Billing
  end
end

# Gemfile der Hauptanwendung
gem "billing", path: "components/billing"
Jede Engine bringt ein eigenes gemspec und eigene Tests mit. Ruby hindert die Hauptanwendung trotzdem nicht daran, Billing::Invoice direkt anzufassen. Die Grenze bleibt Konvention.
Packwerk
An dieser Stelle setzt Packwerk an, ein Gem von Shopify unter MIT-Lizenz, zuletzt erschienen als Version 3.3.1 im August 2026. Es teilt eine Anwendung in Pakete auf und ermöglicht eine statische Prüfung, ob ein Paket Konstanten eines anderen verwendet, ohne diese Abhängigkeit deklariert zu haben. Voraussetzung ist Zeitwerk, der seit Rails 6 mitgelieferte Autoloader.
# components/billing/package.yml
enforce_dependencies: true
dependencies:
  - components/accounts
Nach bin/packwerk init läuft bin/packwerk check in der CI. Bestehende Verstöße landen per bin/packwerk update-todo in einer package_todo.yml. Die arbeitest du nach und nach ab. Stellst du auf enforce_dependencies: strict um, kommen keine neuen Verstöße mehr hinzu. Ob ein Paket ausschließlich seine öffentliche API nach außen zeigt, prüft Packwerk selbst nicht mehr; dieser Check wurde ausgelagert und steckt heute im Gem packwerk-extensions.
Konkret heißt das: Du zerlegst monolithische Anwendungen schrittweise, Paket für Paket, und lieferst währenddessen ganz normal neue Features aus. Das ermöglicht eine Umstellung ohne Feature-Stopp, was bei einem Umbau auf eine Microservice-Architektur kaum gelingt.
Monolith oder Microservices im direkten Vergleich
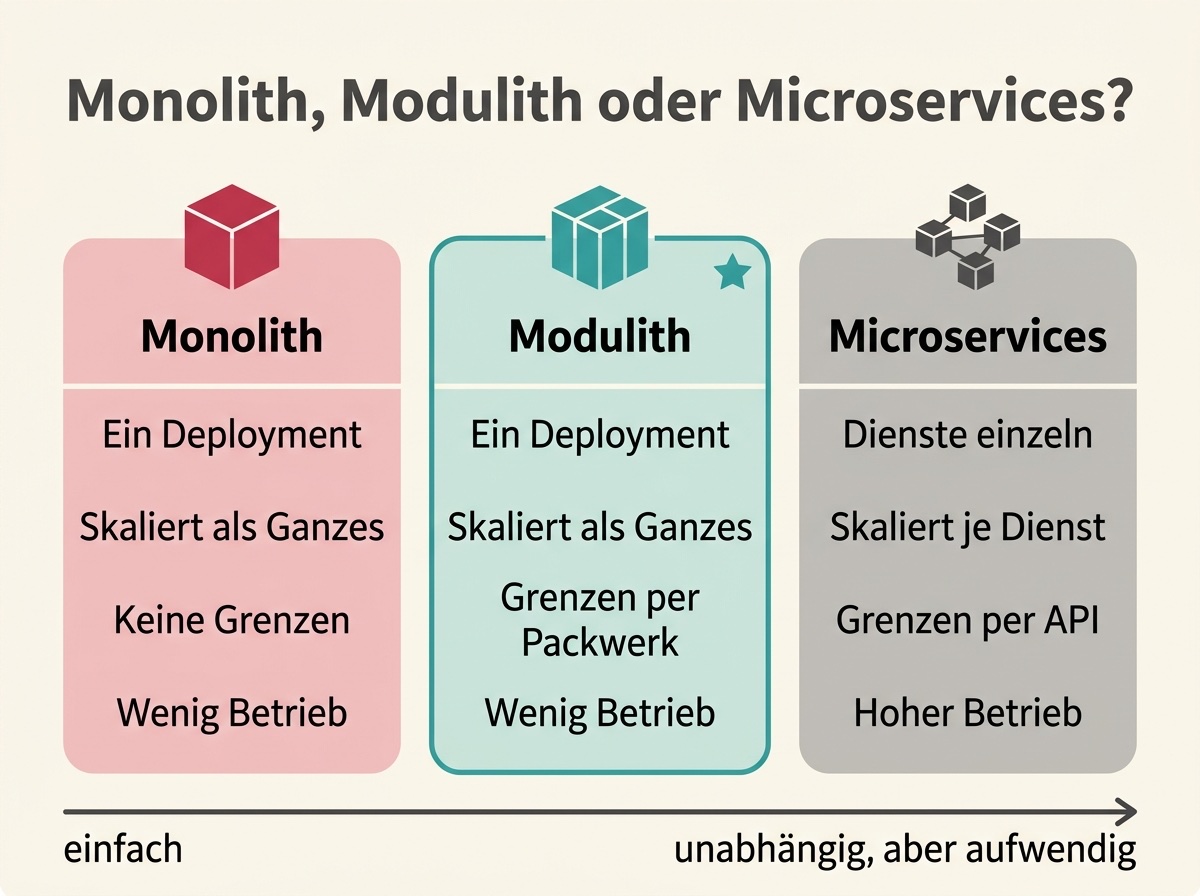
Drei Architekturen im Überblick: Je weiter rechts, desto unabhängiger die Teile und desto höher der Betriebsaufwand.
| Kriterium | Klassischer Monolith | Modulith | Microservices |
|---|---|---|---|
| Deployment | ein Artefakt, ein Release | ein Artefakt, ein Release | jeder Dienst einzeln |
| Skalierung | nur das gesamte System | nur das gesamte System | einzelne Services unabhängig voneinander |
| Transaktionen | Datenbank-Transaktion | Datenbank-Transaktion | Sagas, eventual consistency |
| Grenzen | keine | Engines, Packwerk, CI-Check | Netzwerk und API |
| Fehlersuche | ein Stacktrace | ein Stacktrace | verteiltes Tracing nötig |
| Infrastruktur | ein Server-Setup | ein Server-Setup | Gateway, Service Discovery, Monitoring je Dienst |
| Typische Teamgröße | ein Team | mehrere Teams, ein Repo | viele Teams mit eigenem Release-Zyklus |
Die Vorteile von Microservices liegen beim Deployment und bei der Skalierbarkeit einzelner Komponenten. Bezahlt wird mit erhöhter Komplexität im Betrieb, denn jeder Aufruf zwischen zwei Diensten kann ausfallen oder veraltete Daten liefern. Wo vorher ein Order.transaction reichte, brauchst du Ausgleichsaktionen über mehrere Dienste hinweg. Viele Unternehmen unterschätzen genau diesen Teil, weil er im Architekturdiagramm nur als Pfeil auftaucht.
Dazu kommt die Infrastruktur. Eine Microservices-Architektur braucht Container-Orchestrierung, zentrales Logging und Tracing, und jemand muss das betreiben. Für ein Unternehmen mit acht Entwicklern ist das ein komplexes verteiltes System für ein Problem, das ein Modulith auch löst. Wer Microservices nutzen will, sollte die Nachteile deshalb so ehrlich durchrechnen wie die Vorteile.
Wann sich Microservices lohnen
Es gibt gute Gründe für eine Microservices-Architektur. Fast alle haben mit Organisation und Last zu tun, kaum einer mit der Code-Qualität. Am besten prüfst du sie einzeln.
- Unabhängige Releases sind Pflicht: Mehrere große Teams blockieren sich im gemeinsamen Release-Zug, Continuous Delivery staut sich. Kleine, unabhängige Teams mit eigenem Dienst lösen das.
- Die Lastprofile unterscheiden sich stark: Ein Bildkonverter braucht ein Vielfaches an CPU, und im Monolithen skalierst du für ihn alles mit.
- Ein Teil braucht neue Technologien: Ein Empfehlungsdienst mit Python-Bibliotheken für Machine Learning gehört nicht in einen Rails-Prozess.
- Isolation aus Sicherheitsgründen: Wer Kartendaten verarbeitet, kann den Prüfumfang nach PCI DSS verkleinern, wenn dieser Teil getrennt läuft.
Prüfe, ob mindestens ein Punkt heute zutrifft. Nicht erst in zwei Jahren. Wer Microservices schneidet, die sich eine Datenbank teilen und nur gemeinsam deployt werden können, baut einen verteilten Monolithen. Er hat alle Netzwerkprobleme einer Microservice-Architektur und behält trotzdem den gemeinsamen Release-Zug. In diesem Fall wäre der Monolith die bessere Wahl gewesen.
Sobald Dienste über APIs miteinander kommunizieren, wird die JSON-Schnittstelle zum Vertrag zwischen den Entwicklerteams. Wie du sie stabil hältst, steht im Artikel zu REST-APIs mit Representern in Ruby.
Ein sauber abgegrenztes Modul lässt sich später als eigener Dienst herauslösen, ohne dass der Rest umgebaut werden muss.
Der Weg dazwischen: Module zuerst, Dienste später
Ein Modulith hält dir die Entscheidung offen, und das ist sein größter Vorteil gegenüber beiden Extremen. Nimm ein Paket, das unter Packwerk keine undeklarierten Abhängigkeiten mehr hat und nur über eine kleine öffentliche Schnittstelle angesprochen wird. Das ist ein guter Kandidat. Du ersetzt die Methodenaufrufe durch HTTP-Aufrufe oder Events, ziehst die Tabellen in eine eigene Datenbank und deployst das Modul separat.
Eine Regel lohnt sich schon in monolithischen Systemen: keine Joins und keine Fremdschlüssel über Modulgrenzen. Braucht die Abrechnung den Namen eines Kunden, fragt sie das Modul Accounts über dessen Schnittstelle. Anfangs fühlt sich das umständlich an. Beim Herauslösen ersparst du dir damit den mühsamsten Teil des Umbaus, nämlich das Entwirren der Daten.
Entscheidungshilfe für dein Projekt
Geh die Fragen der Reihe nach durch:
- [ ] Liegt die Geschäftslogik in Service-Objekten oder Operations statt in Callbacks?
- [ ] Sind die fachlichen Module benannt und im Verzeichnisbaum sichtbar?
- [ ] Prüft die CI die Abhängigkeiten zwischen den Modulen, etwa mit Packwerk?
- [ ] Gibt es keine modulübergreifenden Joins mehr?
- [ ] Trifft einer der vier Gründe für Microservices heute nachweisbar zu?
Kannst du die ersten vier Punkte nicht abhaken, ist ein verteiltes System zu früh. Erst wenn alle fünf stimmen, lohnt sich der Schnitt, und zwar zunächst nur für dieses eine Modul. Für neue Rails-Projekte würde ich deshalb mit einem Modulith starten. Die Software bleibt in einem Repository überschaubar, und der Weg zu Microservices ist trotzdem nicht verbaut. Mehr zu Architektur und Werkzeugen findest du in der Rubrik Technik.